약 19분 읽기
무료 CBT 사이트가 답답해서
정보처리기사와 정보보안기사를 준비하며 많은 CBT 사이트를 사용해 보았다. 하지만 대부분의 무료 사이트는 사용자 경험이 부족하고, 성능이 떨어지며, 종종 광고가 도배되어 있어 공부에 집중하기 어려웠다. 또한, 일부 사이트는 기출문제가 최신 정보로 업데이트되지 않아 신뢰성이 떨어지기도 했다. 이런 문제점들은 사용자가 공부에만 집중할 수 있는 환경을 조성하는 데 큰 장애물로 작용했다.
가장 불편했던 점은 UX/UI 측면이었다. 인터페이스가 직관적이지 않아 처음 사용하는 사람에게는 적응하기가 어려웠고, 시험 기능도 제한적이라 실제 시험 환경과 비교했을 때 많은 부분이 부족했다. 특히, 문제를 풀 때마다 페이지가 새로고침되면서 타이머가 초기화되는 등의 불편함이 있었다. 이러한 문제들은 학습의 속도를 떨어뜨렸고, 자연스럽게 더 나은 방법을 고민하게 만들었다.
그리고 적절한 피드백을 받을 수 없는 점도 문제였다. 틀린 문제에 대한 해설이 부족하거나 심지어 없는 경우도 많았다. 사용자 커뮤니티가 활성화되지 않아 질문을 하거나 의견을 교환할 수 있는 공간도 부족했다. 이렇듯 여러 부분에서의 불편함이 결국 내가 직접 새로운 플랫폼을 개발해야겠다는 결심을 하게 만든 계기가 되었다. 이렇게 시작된 프로젝트는 개인적으로도 큰 도전이었다.
처음부터 모든 것을 직접 구축하는 것이 쉬운 일은 아니었지만, 기존의 문제점을 개선할 기회로 삼았다. 무엇보다도 사용자들이 실제 시험처럼 편안하게 문제를 풀 수 있도록 UI/UX를 크게 개선하는 데 주력했다. 또한, 최신 기출문제를 제공하고자 노력했으며, 틀린 문제에 대한 철저한 해설을 제공하여 학습에 가장 큰 도움이 될 수 있도록 만들었다. 이러한 목표는 단순히 나의 불편함을 해결하기 위한 것이 아니라, 같은 문제를 겪고 있을 다른 사람들에게도 도움이 되기를 바라는 마음에서 비롯된 것이었다.
문제 데이터가 전부였다
문제 데이터를 수집하고 가공하는 과정은 생각보다 복잡했다. 개발 초기 단계에서 웹사이트의 성공 여부는 정확하고 풍부한 문제 데이터에 달려 있었다. 최신 기출문제를 준비하기 위해 408페이지에 달하는 PDF를 준비했고, 이를 OCR로 읽어내야 했다. 초반에는 모든 페이지를 하나의 이미지로 추출하고 다시 한 페이지씩 텍스트를 인식하는 데에 많은 시간이 걸렸다. 예상보다 시간이 오래 걸린다는 걸 깨달았다.
OCR을 통해 얻은 결과물은 예상대로 깔끔하지 않았다. 문제의 구조를 유지하면서도 정답과 해설까지 포함해야 했기에, 정규식을 활용하여 데이터를 분리하고 정리하는 작업이 필수적이었다. 문제는 OCR이 인식한 텍스트의 질이 일관되지 않았다는 점이었다. ‘①, ②, ③, ④’ 같은 선지 번호가 ‘(1), (2), (3), (4)’ 또는 ‘O, I, II, III’로 잘못 인식되는 경우가 많았다. 이런 패턴들을 정규식으로 잡아내는 데에 많은 시간이 소요되었다.
OCR 과정의 비효율성은 큰 골칫거리였다. 매번 20분 이상 걸리는 작업을 정규식 하나를 수정할 때마다 반복해야 하는 것은 한참 걸렸다. 그래서 캐시 시스템을 도입하여 OCR 결과를 저장한 후, 필요할 때마다 재사용하도록 했다. 이렇게 하니 다음 수정 때는 3초 만에 결과를 확인할 수 있었다. 이로 인해 개발 속도는 크게 향상되었다.
문제 데이터의 중요성을 체감하며, 데이터를 어떻게 효과적으로 관리하고 처리할 수 있을지를 고민하게 되었다. 결국, 내가 개발한 시스템의 핵심은 기출문제가 아니라 기출문제를 다루는 방식이었다. 사용자가 더 나은 학습 경험을 할 수 있도록 지원하는 게 목표였다. 이런 과정에서 문제 데이터를 어떻게 가공하고 최적화할지는 결국 사용자의 편리함과 직결되었다.
408페이지 OCR에 20분, 정규식 고칠 때마다 20분
처음에는 OCR 결과가 무척 지저분해서 한 번의 OCR 처리를 완료하는 데 20분 이상이 걸렸다. 이 과정에서 한 가지 문제는 OCR 결과를 수정하거나 정규식을 고칠 때마다 20분씩 기다려야 한다는 점이었다. 빠르게 반복적인 테스트와 수정을 할 수 있는 환경이 필요했다. 그래서 OCR 결과를 캐싱하여 작업 시간을 단축하는 방법을 고민하게 되었다. 결국 OCR 결과를 JSON 형태로 저장하고 수정할 때마다 이 캐시를 불러오는 구조를 설계했다.
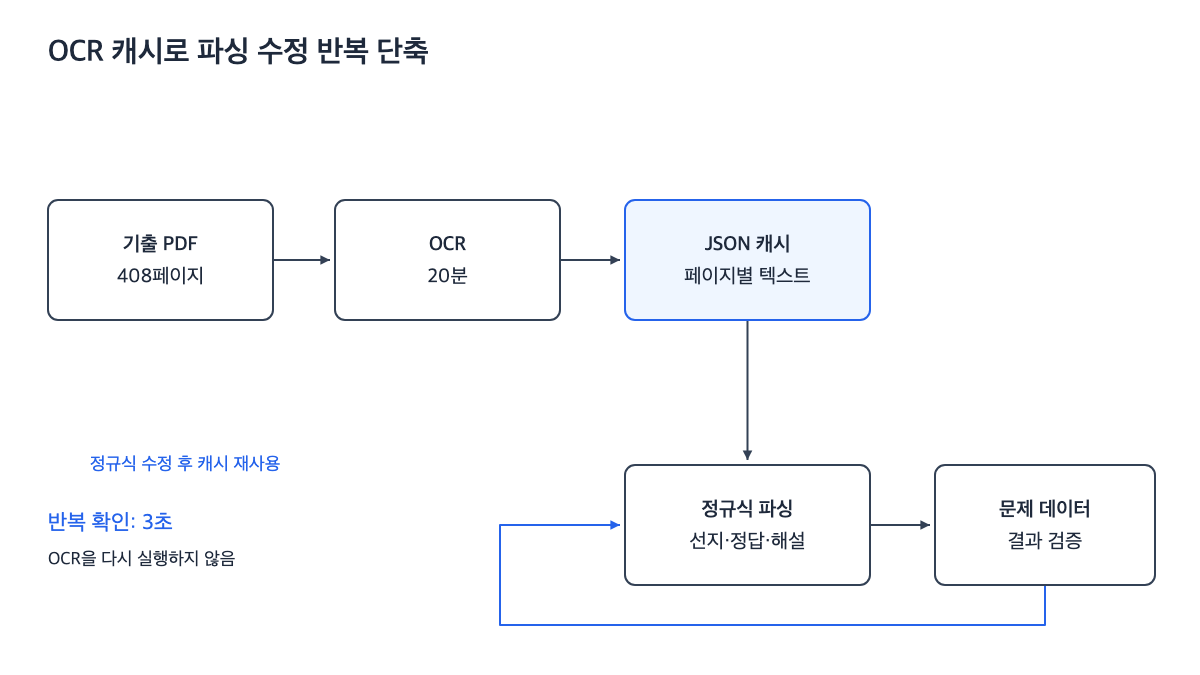
나의 목표는 매번 OCR을 다시 돌리는 대신 저장된 데이터를 이용하여 빠르게 문제를 파싱하고 수정할 수 있게 하는 것이었다. 이 설계가 가능했던 이유는 OCR 처리 시간이 길어도 결과 데이터는 상대적으로 작았기 때문이다. 단순히 데이터를 복사하고 불러오는 방식이 더 빠른 성능을 제공할 수 있음을 깨달았다. 캐시를 사용함으로써 최종적으로 OCR 후 정규식을 수정할 때 3초 미만의 시간을 소요하게 되었다.
def ocr_page(page, lang='kor+eng') -> str:
    """pdfplumber page → tesseract OCR"""
    img = page.to_image(resolution=200).original      # PIL Image
    return pytesseract.image_to_string(
        img, lang=lang, config='--psm 6 --oem 3')

def ocr_all_pages(pdf_path, page_range, use_cache=False, save_cache=False):
    # 408페이지 OCR이 20분. 정규식 고칠 때마다 기다릴 수 없어서 캐시를 뒀다
    if use_cache and CACHE_PATH.exists():
        cached = json.loads(CACHE_PATH.read_text())
        return [cached[str(i)] for i in page_range if str(i) in cached]

    texts = {}
    with pdfplumber.open(pdf_path) as pdf:
        for i in page_range:
            texts[str(i)] = ocr_page(pdf.pages[i])
            if i % 20 == 0:
                print(f"  {i}/{len(pdf.pages)} 페이지")

    if save_cache:
        CACHE_PATH.write_text(json.dumps(texts, ensure_ascii=False))
    return [texts[str(i)] for i in page_range]
OCR 결과를 캐시해서 20분을 3초로 (ocr_sujebi.py)
캐시를 활용하는 시스템 덕분에 정규식 수정 및 결과 검증 시간을 획기적으로 줄일 수 있었다. 20분을 기다리던 작업을 단 3초 만에 완료할 수 있었다. 이 방식 덕분에 데이터 파싱 작업의 쓰기도 높아졌고, 파싱 논리의 오류를 발견하고 수정하는 과정도 훨씬 수월해졌다. 개발 과정에서 불필요한 대기 시간을 줄일 수 있었고, 이렇게 해서 작업의 연속성을 유지하며 개발할 수 있었다.
OCR이 원문자를 뭉갠다
OCR을 사용해 기출문제를 추출하는 과정에서 가장 큰 문제는 OCR 기술의 한계로 인한 원문자의 불완전한 인식이었다. 특히, 문제의 선지 부분에서 ①, ② 같은 기호가 (1), 1), 심지어 O 등으로 잘못 인식되는 경우가 빈번했다. 이로 인해, 자동으로 문제를 정리하고 분류하는 작업이 매우 까다로워졌다. 해결책으로 정규표현식을 사용해 다양한 패턴을 잡는 방법을 생각했다.
이 문제를 해결하기 위해 정규표현식을 활용해 여러 가지 형태로 잘못 인식된 패턴을 모두 잡아내는 코드를 작성했다. 이 코드의 목표는 OCR이 부정확하게 인식한 패턴들을 최대한 포괄하는 것이다. 다양한 가능성을 고려한 패턴을 정의하여, 가능한 모든 경우의 수를 잡아낼 수 있게끔 짰다. 이렇게 하면 설령 OCR이 원문자를 잘못 인식하더라도 원하는 정보를 손쉽게 추출할 수 있다.
# ①②③④ 가 OCR에서 (1), 1), O, ⓵ 등으로 튄다. 전부 잡는다
CHOICE_PAT = re.compile(
    r'(?:[①②③④]|\((?:[1-4])\)|(?:[1-4])\)|[⓵⓶⓷⓸])\s*(.+?)'
    r'(?=(?:[①②③④]|\((?:[1-4])\)|(?:[1-4])\)|[⓵⓶⓷⓸])|해설|정답|$)',
    re.S)

# '20년 4회' → (2020, 4).  두 자리 연도를 4자리로 정규화한다
ROUND_PAT = re.compile(r'(\d{2})년\s*(\d)회')

def parse_question(block: str):
    m = ROUND_PAT.search(block)
    year, rnd = (2000 + int(m.group(1)), int(m.group(2))) if m else (None, None)

    choices = [c.strip() for c in CHOICE_PAT.findall(block)]
    if len(choices) != 4:
        return None                       # 4개가 안 나오면 버린다. 억지로 안 채운다

    ans = re.search(r'정답\s*[::]?\s*([1-4①②③④])', block)
    exp = re.search(r'해설\s*[::]?\s*(.+?)(?=정답|$)', block, re.S)
    return {
        "year": year, "round": rnd,
        "content": CHOICE_PAT.split(block)[0].strip(),
        "choices": choices,
        "answer": normalize_answer(ans.group(1)) if ans else None,
        "explanation": exp.group(1).strip() if exp else None,
    }
OCR이 뭉개놓은 원문자 선지를 여러 패턴으로 잡기
이 접근법을 사용하면서, 여러 패턴을 한꺼번에 잡아내는 것이 중요했다. 이를 위해 다양한 형태의 잘못된 인식 결과를 한꺼번에 처리할 수 있도록 정규식을 확장했다. 이렇게 하자 OCR 결과가 일관되지 않더라도 충분히 대응할 수 있는 유연한 파싱 로직을 갖출 수 있었다. 여전히 몇몇 예외 케이스가 발생하지만, 예전보다 훨씬 안정적으로 문제 데이터를 정리할 수 있었다.
이 작업은 품이 많이 드는 것처럼 보일 수 있지만, 결과적으로 모든 가능한 오류를 다잡기 위해서는 필요했다. 결과적으로, 이러한 방식은 문제 데이터의 신뢰성을 높였고, 이후의 데이터 처리와 분석에 있어서도 큰 도움이 되었다. 정규식을 개선하면서 새로운 예외 케이스도 더욱 쉽게 대처할 수 있었고, 데이터 품질 역시 점차 향상되었다.
실제 시험처럼 만들기
기존의 무료 CBT 사이트들은 실제 시험 환경과는 거리가 멀었다. 그래서 수험자가 시험을 보는 동안 시간의 흐름을 실감하지 못하거나, 과목 별로 집중하기 어려운 문제가 있었다. 이를 해결하기 위해 실제 시험과 비슷한 경험을 주는 것이 중요했다. 타이머를 통해 시간 관리 능력을 기르고, 과목 별로 색상을 자동 배정하여 시각적인 구분이 쉽게 이루어지도록 했다.
타이머는 커스텀 훅으로 구현하여 다양한 컴포넌트에서 재사용할 수 있도록 설계했다. 시간 관리의 중요성을 강조하기 위해 인터페이스 상에서 시간을 시각적으로 강조할 수 있게 했고, 과목 색상은 팔레트를 사용하여 자동으로 배정되도록 했다. 팔레트 시스템은 과목이 추가되더라도 색상이 자동으로 가장 적합하게 배정되도록 하여 유지보수의 편리함을 더했다.
function useTimer() {
  const [seconds, setSeconds] = useState(0);
  useEffect(() => {
    const id = setInterval(() => setSeconds((s) => s + 1), 1000);
    return () => clearInterval(id);       // 언마운트 때 반드시 정리
  }, []);
  const h = Math.floor(seconds / 3600);
  const m = Math.floor((seconds % 3600) / 60);
  const s = seconds % 60;
  if (h > 0)
    return `${h}:${String(m).padStart(2, "0")}:${String(s).padStart(2, "0")}`;
  return `${String(m).padStart(2, "0")}:${String(s).padStart(2, "0")}`;
}

// 과목이 몇 개일지 모르니 팔레트에서 순서대로 꺼내 쓴다
const SUBJECT_COLORS: Record<string, string> = {};
const SUBJECT_PALETTE = [
  "bg-blue-500", "bg-emerald-500", "bg-orange-500",
  "bg-purple-500", "bg-rose-500", "bg-cyan-500",
];
let paletteIdx = 0;

function getSubjectColor(name: string) {
  if (!SUBJECT_COLORS[name]) {
    SUBJECT_COLORS[name] = SUBJECT_PALETTE[paletteIdx % SUBJECT_PALETTE.length];
    paletteIdx++;
  }
  return SUBJECT_COLORS[name];
}
타이머는 훅으로, 과목 색상은 자동 배정 (JcbtExamClient.tsx)
타이머는 단순히 시간 흐름을 보여주는 것이 아니라, 시험 중인 사용자가 남은 시간을 직관적으로 파악할 수 있도록 돕는다. 이로 인해 시간 초과 위험을 사전에 관리할 수 있게 되었고, 실제 시험을 대비하는 데 효과적인 훈련 도구가 되었다. 과목 별 색상 배정은 시험 문제를 시각적으로 구분하는 데 도움이 되어, 사용자는 자신의 위치를 즉각적으로 인식할 수 있었다. 이 방식으로 프론트엔드가 실제 시험과 유사한 경험을 제공하게 되었다.
새로고침 사고 방지
CBT 사이트를 개발하면서 사용자가 새로고침을 할 때 진행 중이던 문제를 잃어버리는 문제가 발생했다. 시험 중단과 같은 불편함을 초래할 수 있는 부분이어서, 손 안 가게 해결할 필요가 있었다. 이 문제를 해결하기 위해 localStorage를 사용하기로 했다. 사용자가 풀고 있는 문제의 상태를 브라우저에 저장해서 새로고침 후에도 바로 복구할 수 있도록 했다. 이 방식은 서버 부하를 줄이면서도 사용자의 경험을 개선할 수 있는 좋은 방법이었다.
localStorage는 사용자의 브라우저에 데이터를 저장하는 기능을 제공하며, 페이지가 새로고침되거나 닫혀도 데이터가 유지된다. 이를 활용하면 새로고침 시에도 사용자가 마지막으로 풀던 문제에 대한 데이터를 계속 사용할 수 있다. 사용자가 특정 문제의 답을 제출할 때마다 그 정보를 localStorage에 갱신했다. 이는 사용자가 어디까지 문제를 풀었는지 기억하도록 도와주어, 불필요한 반복을 줄였다.
// 문제 위치를 localStorage에 저장한다. 시험 중 실수로 새로고침하면 곤란하다
const posKey = `exam-pos-${sessionId}`;
const initialized = useRef(false);

useEffect(() => {
  if (initialized.current || questions.length === 0) return;
  const saved = Number(localStorage.getItem(posKey) ?? 0);
  if (saved > 0 && saved < questions.length) setCurrentIdx(saved);
  initialized.current = true;             // 최초 1회만 복원
}, [questions.length, posKey]);

useEffect(() => {
  if (initialized.current) localStorage.setItem(posKey, String(currentIdx));
}, [currentIdx, posKey]);
새로고침해도 풀던 문제로 돌아오게
localStorage에 저장된 문제 정보는 페이지가 로드될 때 다시 불러와졌다. 이렇게 함으로써 사용자 경험을 끊김 없이 이어갈 수 있었다. 만약 localStorage에 데이터가 존재하지 않는 경우에는 초기 상태로 페이지가 시작되도록 설계했다. 이로 인해 사용자가 의도하지 않게 데이터가 유실되는 경우를 최소화할 수 있었다. 덕분에 사용자는 마치 실제 시험 환경에서 계속 진행하는 것처럼 학습할 수 있었다.
지금 쓰는 상태
현재까지 개발한 CBT 사이트는 기본적인 기능들이 모두 구현되어 있는 상태다. 사용자는 사이트에 접속하여 기출문제를 풀고, 결과를 확인할 수 있으며, 오답노트를 통해 틀린 문제를 다시 학습할 수 있다. 프론트엔드와 백엔드 모두 안정적인 상태로 운영되고 있으며, Docker로 배포한 덕분에 서버 관리도 용이하다. 하지만 몇 가지 개선할 부분이 남아 있다.
가장 먼저, 문제 데이터의 정확도를 높이는 작업이 필요하다. OCR 결과물을 기반으로 정규식을 사용하여 데이터를 추출했지만, 여전히 오류가 발생할 가능성이 있다. 특히 한글과 영어가 섞인 경우나 글자의 위치가 미묘하게 다른 경우에는 정규식이 제대로 작동하지 않는 경우가 있었다. 이를 개선하기 위해 OCR 라이브러리나 방법을 더 연구하고, 정규식을 더욱 견고하게 구성할 계획이다.
또한, 사용자 경험 향상을 위한 UI/UX 개선도 고려 중이다. 현재 제공되는 문제 풀이 인터페이스는 기본적인 기능은 갖추고 있지만, 모바일 기기에서의 사용성을 더 개선할 수 있다. 반응형 디자인을 통해 다양한 화면 크기에 대응할 수 있도록 작업을 진행하고 있다. 더불어 시험 종료 시점에서의 피드백 시스템도 추가하여, 사용자가 학습 결과를 보다 명확히 파악할 수 있도록 할 예정이다.
마지막으로, 사용자 데이터를 분석하여 보다 개인화된 학습 경험을 제공할 방법을 모색 중이다. 현재는 문제 풀이 기록과 오답노트 등 기본적인 기능을 제공하지만, 이를 바탕으로 개인에게 맞춤 학습 경로를 제안하는 알고리즘을 도입하고자 한다. 이렇게 해서 사용자가 더욱 효과적으로 학습할 수 있는 환경을 제공하는 것이 목표다. 이러한 개선사항들을 꾸준히 업데이트하면서 사용자들에게 더 나은 학습 도구를 제공할 예정이다.
함께 볼 글
이 글과 이어지는 내용은 아래에 정리해뒀다.
