약 20분 읽기
찬양팀 악보 키 바꾸는 일이 반복돼서
찬양팀 연습이 있을 때마다 악보의 조성을 바꿔야 하는 일이 자주 생겼다. 원래의 키가 너무 높거나 낮아서 부르기 힘들다면, 반주자와 함께 조정을 해야 했고, 이는 생각보다 번거로웠다. 특히 반주자가 손으로 일일이 악보를 다시 써야 하는 경우가 많았기 때문에 시간이 많이 소요되었다. 이 문제를 해결하기 위해 자동으로 악보의 키를 변환하는 도구가 필요했다.
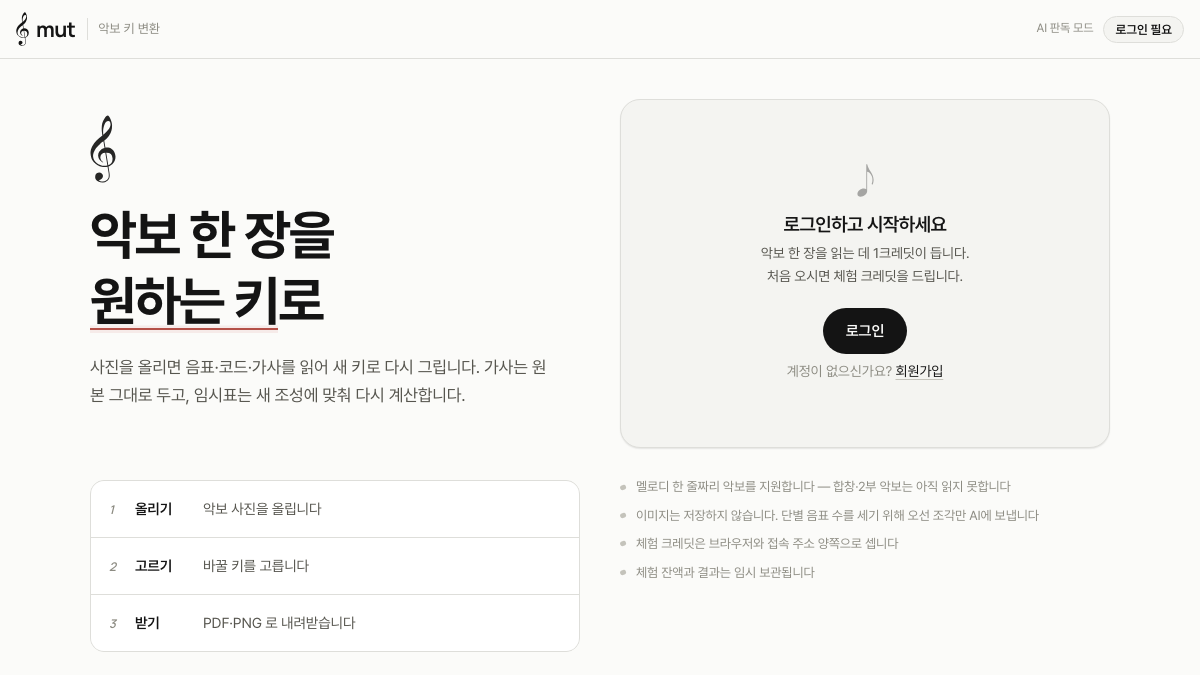
악보의 키를 변환하는 작업은 단순히 음표의 위치를 옮기는 것만으로 해결되지 않았다. 조성이 바뀌면 자연스럽게 임시표도 변화해야 했기 때문이다. 하지만 기존에 만들었던 방법으로는 이러한 부분을 자동으로 처리하기가 어려웠다. 결국, 처음부터 다시 접근해야겠다는 생각이 들었다. MusicXML을 이용해 음표의 구조를 뽑아 재조판하는 방식을 채택했다. 이 방법은 더 복잡한 작업이었지만, 결과적으로 더 정확하고 신뢰할 수 있는 결과를 제공했다.
음표를 인식하는 작업은 처음부터 쉽지 않았다. 저작권 문제로 인해 공개된 실제 악보를 학습에 사용할 수 없었기 때문이었다. 그래서 합성 데이터를 만들어 학습시킬 수밖에 없었다. 랜덤으로 생성된 음표들과 오선을 이용해 합성 악보 6000장을 만들어 YOLO 모델을 학습시켰다. 이 과정에서 학습 데이터의 라벨이 정확하지 않아 성능이 떨어지는 문제를 겪기도 했다. 하지만 라벨의 정확도를 높이면서 다시 학습시킨 결과, mAP가 크게 개선되었다.
이 프로젝트는 여러 차례 좌절을 겪었지만, 그때마다 방향을 수정하며 해결책을 찾았다. 최종적으로는 음표의 위치를 인식하고, 새로운 조성에 맞게 재조판된 악보를 자동으로 생성해내는 시스템을 구축할 수 있었다. 이는 찬양팀의 연습 시간 절약과 편의성을 크게 높여주었다.
픽셀을 옮기는 방식으로 짰다가 버렸다
프로젝트 초기 단계에서는 원본 이미지의 음표를 픽셀 단위로 위아래로 옮기는 방식으로 조성을 변경하려 했다. 이 방법은 처음에는 간단하고 효과적으로 보였다. 음표의 위치만 변경하면 되는 것처럼 보였기 때문에 빠르게 구현할 수 있었다. 그러나 곧바로 이 접근 방식의 한계에 부딪혔다. 임시표(#, b)를 적절히 조정하지 못하는 문제가 발생했다. 단순히 음표의 위치만 변경하는 것으로는 악보의 조성이 바뀔 때 필요한 복잡한 계산을 수행할 수 없었다.
픽셀 단위로 음표를 옮기는 방식은 음표의 물리적 위치만 변할 뿐, 악보의 화성적 구조를 반영하지 못했다. 예를 들어, C장조의 F음표는 D장조에서는 G#로 변경되어야 하지만, 픽셀 이동 방식으로는 이러한 구조적인 변화를 처리할 수 없었다. 이로 인해 음표의 음높이와 임시표를 제대로 반영하지 못하면서, 결과적으로 음악적으로 맞지 않는 악보가 생성되었다. 이러한 한계는 시스템 전체의 신뢰성을 떨어뜨렸다.
결국 이 방식을 포기하고 MusicXML을 기반으로 한 재조판 방식으로 방향을 전환했다. MusicXML은 악보의 구조적 정보를 포함하고 있어, 조성 변경 시 필요한 모든 정보를 정확하게 제공할 수 있었다. 이렇게 해서 악보의 음표, 임시표, 화음 등을 체계적으로 관리할 수 있게 되었다. 이는 프로젝트를 처음부터 다시 짜야 한다는 의미였지만, 결국 더 나은 결과를 불러왔다. 이전 방식의 한계를 넘어서기 위한 결정적인 전환점이었다.
음높이는 계산으로 구한다
처음엔 음표의 음높이를 AI 모델을 통해 추론하려고 했다. 하지만 이는 정확성 문제로 이어졌다. AI 모델이 아무리 정교해도 이미지의 해상도나 음표의 특이한 모양 때문에 오차가 발생할 수 있었다. 특히 음표 간의 상대적 위치가 중요할 때, AI가 미세하게 잘못 인식한 부분이 전체 결과에 큰 영향을 줄 수 있었다. 그래서 AI 대신 명확한 좌표 계산 방식을 도입하게 되었다.
이 방법은 특정 음표의 머리 부분의 y좌표를 기준으로 한다. 첫 오선의 y좌표와의 차이를 구한 뒤, 이를 오선 간의 반칸 높이로 나누어 어떤 음높이인지 계산한다. 이 방식은 모든 오선이 일정한 간격을 유지하고 있다는 점을 활용한다. 계산된 음높이는 임의의 변수에 의해 영향을 받을 여지가 적어 상당히 안정적이다.
def pitch_from_y(head_y: float, staff_top_y: float, spacing: float) -> int:
    """음표 머리 y좌표 → 오선 기준 몇 번째 칸인지.

    spacing은 오선 두 줄 사이 간격. 반칸이 기본 단위다.
    (머리 y - 첫 줄 y) / (spacing/2) 를 반올림하면 스텝이 나온다.
    위로 갈수록 y가 작아지니 부호를 뒤집는다.
    """
    half = spacing / 2.0
    steps = -round((head_y - staff_top_y) / half)
    return steps

def transpose_diatonic(step: int, semitones: int, src_fifths: int) -> tuple:
    """온음계 단수 + 반음 보정. 여기서 임시표가 결정된다.
    픽셀만 옮기면 이 계산을 할 수 없어서 방식을 전부 바꿨다."""
    letter = STEP_TO_LETTER[step % 7]
    octave = 4 + step // 7
    midi = LETTER_TO_MIDI[letter] + 12 * octave + key_alter(letter, src_fifths)
    new_midi = midi + semitones
    dst_fifths = (src_fifths + semitones * 7) % 12
    return midi_to_spelled(new_midi, dst_fifths)
음높이는 AI가 아니라 좌표 계산으로 — 이게 제일 정확하다
나중에 검증하면서 이 방법이 얼마나 정확한지를 확인할 수 있었다. 네 종류의 검증용 악보를 통해 모든 음표 위치를 정확히 계산해낼 수 있었다(각각 129/129, 197/197, 202/202, 199/199). 이는 수작업으로 진행했을 때 발생할 수 있는 실수를 완벽히 줄여주었다. 계산 방식은 단순하지만 정확성 면에서 우수했고, 이렇게 해서 음표의 위치를 안정적으로 파악할 수 있었다.
실제 악보를 학습에 못 쓰는 문제
프로젝트를 진행하면서 가장 큰 문제 중 하나는 실제 악보 데이터를 학습에 사용할 수 없다는 점이었다. 대부분의 악보는 저작권이 보호되고 있어 이를 사용하면 법적 문제가 발생할 수 있다. 그래서 처음에는 실제 악보를 사용하지 않고도 AI 모델을 학습시킬 방법을 찾아야 했다. 결론은 합성 데이터를 생성하는 것이었다. 합성 데이터를 통해 실제 악보와 유사한 환경을 제공하면서도 저작권 문제를 피할 수 있었다.
악보의 오선과 음표를 랜덤 배치하는 스크립트를 생성해 총 6000장의 합성 데이터를 만들었다. 이 방법으로 학습 과정에서 필요한 다양한 조합과 변수를 제공할 수 있었다. 랜덤하게 배치된 음표들은 모델이 실제 악보에서 다양한 위치와 조합의 음표를 인식할 수 있도록 도와주었다. 그리고 이러한 접근 방식은 데이터의 다양성과 양을 확보할 수 있어 모델의 일반화 성능을 높이는 데 효과적이었다.
# tools/gendata.py — 라벨을 정확히 아는 악보를 직접 그린다
def synth_page(rng, n_staves=6):
    W, H = 1240, 1754                      # A4 200dpi
    img = Image.new("L", (W, H), 255)
    d = ImageDraw.Draw(img)
    labels = []

    for si in range(n_staves):
        top = 180 + si * 240
        spacing = rng.uniform(6.0, 7.0)    # 실제 악보 오선 간격 분포
        for ln in range(5):                # 오선 5줄
            y = top + ln * spacing
            d.line([(90, y), (W - 90, y)], fill=0, width=1)

        x = 200
        while x < W - 140:
            step = rng.randint(-6, 10)
            cy = top - step * (spacing / 2)
            rx, ry = spacing * 0.62, spacing * 0.46
            filled = rng.random() > 0.25
            d.ellipse([x - rx, cy - ry, x + rx, cy + ry],
                      fill=0 if filled else 255, outline=0)
            # 라벨은 그린 좌표 그대로. 여기가 50%였던 게 문제였다
            cls = 0 if filled else 1
            labels.append((cls, x / W, cy / H, (2 * rx) / W, (2 * ry) / H))
            x += rng.uniform(spacing * 3.2, spacing * 6.0)

    return img, labels

# yolo train model=yolo11n.pt data=synth.yaml imgsz=960 epochs=16 device=mps
# → mAP50 0.987 / mAP50-95 0.806 (M4 Pro, 4.8시간)
합성 데이터 6000장으로 학습 — 실제 악보는 저작권 때문에 못 쓴다
합성 데이터를 사용함으로써 얻은 가장 큰 이점은 데이터의 라벨을 정확히 알 수 있다는 점이었다. 실제 악보를 사용했다면 라벨링 작업에서 많은 시간이 소요되었을 것이다. 그러나 합성 데이터를 사용함으로써 이러한 문제를 피할 수 있었다. 특히, 초기에는 음표의 머리 위치를 대충 잡아 라벨 정확도가 낮았지만, 이를 개선함으로써 학습 성능을 크게 향상시킬 수 있었다. 최대 mAP50 0.987의 성과를 낼 수 있었던 것도 이러한 정확한 라벨링 덕분이었다.
mAP가 안 오르던 이유는 라벨이었다
악보의 음표 검출에서 mAP가 오르지 않았던 근본적인 이유는 라벨의 부정확함 때문이었다. 합성 데이터를 생성할 때, 나는 음표의 머리 위치를 대충 잡아 라벨을 만들었다. 결과적으로, 이 부정확한 라벨 때문에 모델이 제대로 학습되지 않았다. 제대로 된 위치를 학습할 수 없으니 정확한 결과를 기대할 수 없었다. 학습 결과가 기대에 미치지 못한 것은 이러한 기본적인 라벨링의 실수에서 비롯된 것이었다.
라벨의 부정확성을 해결하기 위해 합성 데이터 생성 과정을 수정했다. 처음에는 각 음표의 머리 위치를 대충 배치했지만, 이는 결국 모델의 예측 성능에 큰 영향을 미쳤다. 그래서 라벨의 정확도를 100%로 끌어올리기 위해 음표 머리의 좌표를 정확히 맞추는 방식으로 변경했다. 이 조정이 있은 후, 모델의 학습 성능은 체감될 만큼 나아졌다. 이런 작은 조정이 얼마나 큰 차이를 만드는지 직접 체감할 수 있었다.
이러한 개선은 단순한 숫자 이상의 의미가 있었다. 강화된 라벨링 덕분에 mAP50이 0.987까지 상승할 수 있었다. 라벨의 품질이 얼마나 중요한지를 깨달은 순간이었다. 합성 데이터 생성 과정에서의 작은 차이가 결과적으로 큰 성과로 이어졌다. 정확한 라벨링이 모델의 성능에 있어 결정적인 역할을 한다는 것을 명확히 느꼈던 경험이었다.
이 경험을 통해 데이터의 품질, 특히 라벨링의 정확성이 얼마나 중요한지를 다시금 깨달았다. 데이터 준비 과정에서의 작은 실수가 모델의 전체 성능을 좌우할 수 있다. 그래서 나는 이 프로젝트에서 라벨링의 정확성을 계속해서 검토하고, 필요할 때마다 개선해 나가기로 했다.
어려운 판독만 비싼 모델로
음표를 검출하고 음높이를 계산하는 부분까진 YOLO11n 모델과 수학적 계산으로 해결할 수 있었다. 하지만 악보의 복잡한 구조를 인식하는 문제에 직면하게 됐다. 단순히 음표의 위치와 높이만으로는 음가나 마디, 이음줄 같은 세부 정보를 정확히 추출할 수 없었다. 이러한 구조적 요소를 판독하는 데는 고급 AI 모델이 필요했다. 기존의 방식을 고수했다면 그 복잡성을 커버하기 위해 더 많은 자원을 소모해야 했을 것이다.
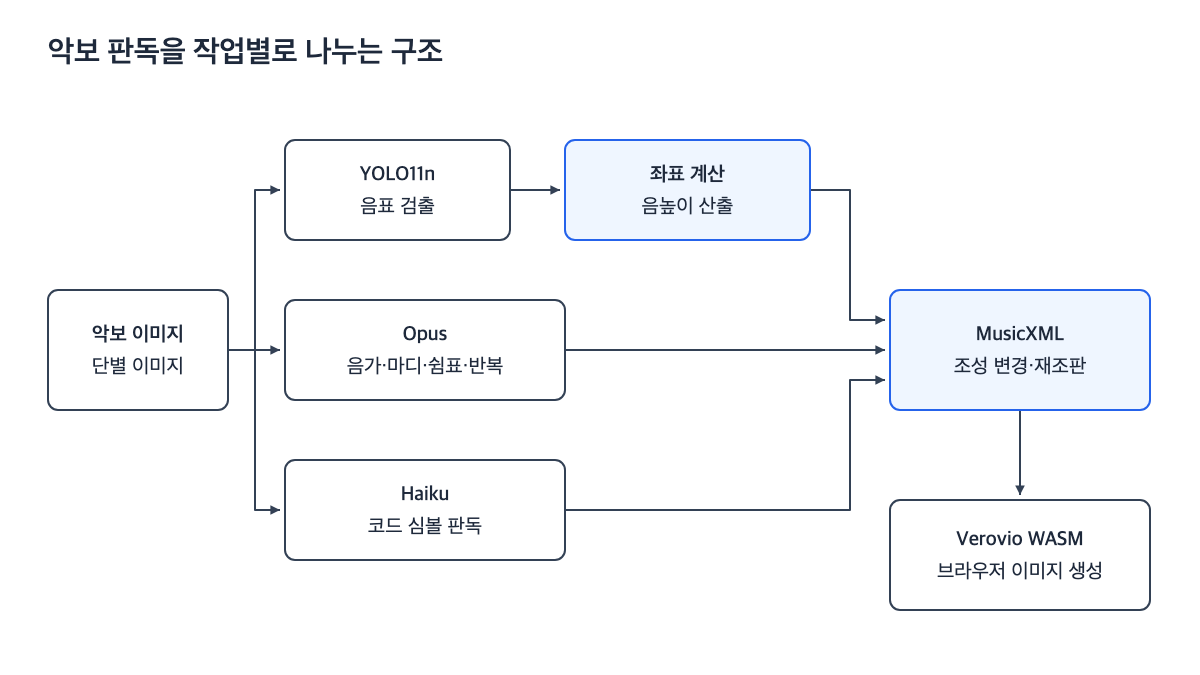
그래서 복잡한 판독이 필요한 부분만 Claude Opus와 같은 비싼 모델을 사용하기로 했다. 이 모델은 단별로 확대한 이미지를 입력받아, 각 요소를 정밀하게 분석한다. 이렇게 함으로써 불필요한 리소스 낭비를 줄일 수 있었고, 전체적인 속도를 높일 수 있었다. 이러한 접근 방식은 특히 복잡한 구조를 빠르게 처리하는 데 유리했다.
# 구조 판독(음가·마디·쉼표·반복)은 어렵다 → Opus
# 코드 심볼 읽기는 쉽다 → Haiku. 전부 Opus로 돌릴 이유가 없다
STRUCTURE_MODEL = "claude-opus-4-5"
CHORD_MODEL     = "claude-haiku-4-5-20251001"

def read_structure(staff_img_b64: str, staff_no: int) -> dict:
    body = {
        "model": STRUCTURE_MODEL,
        "max_tokens": 4096,
        "messages": [{
            "role": "user",
            "content": [
                {"type": "image", "source": {
                    "type": "base64", "media_type": "image/png",
                    "data": staff_img_b64}},
                {"type": "text", "text": (
                    f"{staff_no}번째 단이다. 마디선 위치, 각 음표의 음가, "
                    "쉼표, 이음줄, 도돌이표와 볼타를 JSON으로 내라. "
                    "확실하지 않은 마디는 uncertain: true 로 표시해라.")},
            ],
        }],
    }
    req = urllib.request.Request(
        "https://api.anthropic.com/v1/messages",
        data=json.dumps(body).encode(),
        headers={"content-type": "application/json",
                 "x-api-key": os.environ["ANTHROPIC_API_KEY"],
                 "anthropic-version": "2023-06-01"},
        method="POST")
    with urllib.request.urlopen(req, timeout=180) as r:
        return json.loads(json.loads(r.read())["content"][0]["text"])
모델을 작업 난이도에 맞춰 나눠 쓴다
Claude Opus를 사용하면서도 모든 작업을 이 모델에 의존하지 않았다. 코드 같은 비교적 간단한 텍스트 판독은 Claude Haiku로 대체했다. 이 모델은 상대적으로 저렴하지만 코드의 정확한 판독에는 충분한 성능을 발휘했다. 이런 방식으로 여러 모델을 적재적소에 활용함으로써 전체 시스템의 비용을 빠르게 관리할 수 있었다. 결과적으로 각 작업의 특성에 맞는 모델을 선택함으로 인해 더 정밀한 판독을 수행할 수 있게 되었다.
서버가 이미지를 만들지 않게 설계한 이유
뮤트 프로젝트에서 가장 신경 쓴 부분 중 하나는 저작권 문제였다. 악보 관련 프로젝트에서는 서버가 이미지나 음악 파일을 직접 생성하거나 저장하는 경우 저작권 침해 소지가 크다. 원본 악보 이미지를 서버에 저장하는 순간, 법적 책임이 발생할 수 있다. 그래서 서버가 이미지를 저장하거나 생성하지 않도록 설계했다.
대신 서버는 악보에서 추출한 좌표와 코드 텍스트만 반환하도록 했다. 이 방식으로 서버는 법적인 책임에서 자유로워지고, 사용자 측에서 필요한 악보 이미지를 직접 조합할 수 있게 된다. 이렇게 하면 서버의 부담도 줄어들고, 사용자는 자신의 브라우저에서 작업을 완료할 수 있다.
def build_geometry(img, ink, staves, src_fifths: int = 0) -> dict:
    """브라우저가 픽셀을 옮기는 데 필요한 좌표만 모아 보낸다.

    서버가 악보 이미지를 만들지 않는다(=복제물을 생성하지 않는다).
    좌표와 코드 텍스트는 사실 정보고, 합성은 브라우저에서 일어난다.
    업로드된 원본은 저장하지 않는다.
    """
    spacing = cv.median_spacing(staves)
    strict = cv.remove_staff_lines(ink, staves, protect_noteheads=False)
    out = []
    for st in staves:
        # 음자리표 + 조표 + 박자표 구간은 움직이지 않는다
        head_x = render.header_end_x(st, spacing)
        out.append({
            "top": st.top, "spacing": st.spacing,
            "header_end_x": head_x,
            "notes": [{"x": n.x, "y": n.y, "step": n.step} for n in st.notes],
        })
    return {"staves": out, "threshold": cv.otsu(ink), "src_fifths": src_fifths}
서버는 좌표만 준다 — 이미지 합성은 브라우저에서
악보 이미지는 Verovio WASM을 통해 브라우저에서 생성된다. 사용자가 로컬에서 생성하는 방식이라 복제물 생성에 대한 책임이 사용자에게 있다. 서버는 이미지의 정보를 저장하지 않기 때문에, 사용자는 개인적인 용도로만 데이터를 사용하게 된다. 이는 저작권 문제를 방지하는 데 결정적인 역할을 했다.
검증 결과
뮤트 프로젝트의 검증 단계를 진행하면서 다양한 방식으로 악보 변환의 정확성을 평가했다. 가장 먼저 확인한 것은 음표의 검출 정확도였다. YOLO11n 모델을 사용해 음표를 검출한 결과, 네 종류의 검증용 악보에서 음표 검출이 100% 정확하게 이루어졌다. 129개, 197개, 202개, 199개의 음표 각각 모든 경우에서 정확한 변환이 이루어졌다는 것을 확인했다. 이 데이터는 기본적으로 모델의 신뢰성을 뒷받침해 주는 중요한 지표였다.
이어 Claude Opus를 사용한 악보의 구조 판독도 검증했다. 각 단별로 확대한 이미지를 입력했을 때 쉼표, 이음줄, 반복기호 등 다양한 요소들을 정확히 인식할 수 있었다. 이러한 정확성은 악보 변환의 세부적인 부분까지 정확하게 처리할 수 있음을 의미한다. 코드 인식 부분에서도 Claude Haiku 모델이 C, Am7 같은 코드들을 정확하게 판독하여 변환 성능에 기여했다.
또한, 서버의 데이터 처리 방식도 검증 과정에서 중요하게 다뤄졌다. 서버는 좌표와 코드 텍스트만 돌려주고 이미지를 저장하지 않음으로써 저작권 문제를 방지하는 데 성공했다. 이는 사용자에게 데이터의 개인적 사용에 대한 책임을 부여하며, 복제물 생성의 법적 문제를 최소화하는데 큰 도움이 됐다. 이로 인해 사용자는 안심하고 악보 변환 기능을 활용할 수 있었다.
마지막으로, 사용자가 로컬에서 Verovio WASM을 통해 생성한 악보의 시각적 결과물도 검토했다. 이 과정은 전체적인 변환의 결과물을 눈으로 확인하는 단계였으며, 실제 악보와 비교해도 변환 품질에서 큰 차이가 없었다. 이러한 검증 과정을 통해 뮤트 프로젝트의 기능이 실사용 환경에서도 충분히 적용 가능하다는 확신을 얻을 수 있었다.
함께 볼 글
이 글과 이어지는 내용은 아래에 정리해뒀다.
