약 18분 읽기
개발자가 위탁판매를 해본 이유
개발자인 내가 과일 위탁판매에 뛰어든 이유는 단순히 수익을 올리기 위한 것이 아니었다. 처음에는 친구의 추천으로 시작했지만, 금방 이 일이 가진 복잡한 프로세스에 매료됐다. 수작업 정산과정을 목격하고 나니, 이 일을 자동화할 수 있겠다는 생각이 들었다. 특히 매일매일 반복되는 수작업이 개발자의 손길을 기다리고 있었다.
일상적인 프로그래밍 작업에서 벗어나 색다른 도전을 하고 싶다는 욕구도 컸다. 기존의 업무와는 전혀 다른 분야였지만, 새로운 분야가 주는 자극은 흥미로웠다. 과일이라는 현실적인 상품을 다루면서, 데이터의 흐름을 직접 눈으로 확인할 수 있는 점도 매력적이었다. 이는 곧 프로그래밍을 통해 문제를 해결하고, 실질적인 변화를 만들어낼 수 있다는 자신감으로 이어졌다.
물론 위탁판매라는 새로운 분야를 이해하는 데는 시간이 걸렸다. 과일의 종류와 등급, 무게에 따라 달라지는 여러 조건들을 고려해야 했고, 산지별로 다른 조건들도 파악해야 했다. 하지만 이러한 과정에서 배운 것들은 단순히 개발 기술을 넘어, 비즈니스 마인드를 키우는 데도 큰 도움이 됐다. 개발자로서의 경험을 더해 실질적인 비즈니스 프로세스를 이해하게 된 셈이다.
물론 모든 게 순조롭지는 않았다. 초기에는 엑셀 파일과 씨름하고, 복잡한 매핑 테이블을 다루느라 애를 먹기도 했다. 하지만 이런 시행착오를 거치면서 점차 능숙해졌고, 결국엔 자동화된 시스템을 구축할 수 있었다. 이 경험은 단순한 개발 기술을 넘어 문제 해결 능력을 키우는 좋은 계기가 되었다.
저녁마다 한두 시간이 날아갔다
매일 저녁, 나는 대량의 주문 내역을 엑셀 파일로 받아 처리하는 데 많은 시간을 할애해야 했다. 주문서에는 다양한 과일의 종류와 수량이 적혀 있었지만, 이를 정리하고 정산하는 과정은 단순하지 않았다. 수작업으로 데이터를 입력하고, 계산하고, 다시 확인하는 모든 과정이 반복되었다. 그 때문에 저녁 시간이 순식간에 소모되곤 했다. 이 시간들은 결코 되돌릴 수 없는 것들이었다.
주문 내역에 대응하는 전자세금계산서를 확인하는 일도 별개의 도전 과제였다. HTML 파일을 열어 하나씩 내용을 맞춰보는 것은 고된 작업이었다. 파일의 구조가 일정하지 않아 위치로만 항목을 구분해야 했고, 그 과정에서 실수가 발생하기도 했다. 특정 항목을 놓쳐 다시 확인하는 일도 발생하면서, 엄청난 스트레스를 받았다. 매일 이런 일을 반복하는 것은 결코 쉬운 일이 아니었다.
게다가, 산지별로 다른 수수료를 계산하고, 각기 다른 조건들을 고려하여 정산서를 작성하는 작업이 추가로 기다리고 있었다. 수많은 변수들 속에서 정확성을 유지하는 것은 쉽지 않았다. 작은 실수가 큰 문제로 이어질 수 있었기 때문에, 하나하나 신중하게 다뤄야 했다. 그만큼 작업 시간이 늘어났고, 정신적으로도 매우 소모적이었다.
이 모든 작업들이 수작업으로 이루어져야 했기에, 그날의 마감을 맞추는 일이 항상 부담이었다. 시간과의 싸움 속에서, 반복되는 실수나 누락을 피하려는 노력은 끝이 없었다. 하지만 매일 저녁 그런 시간들을 잃어버린다는 사실은 늘 아쉬움으로 남았다. 이런 상황을 개선하고자 하는 열망이 자동화 시스템 구축의 동력이 되었다.
전자세금계산서 HTML에는 클래스명이 없다
국세청의 전자세금계산서 HTML을 파싱하는 작업은 생각보다 까다로웠다. 일반적으로 웹 페이지를 파싱할 때는 각 요소에 붙어 있는 클래스명이나 ID를 활용한다. 하지만 이 경우, 제공되는 HTML에는 클래스명이 전혀 없었다. 테이블 구조로 되어 있었지만, 각 열이 어떤 정보를 담고 있는지 알 수 있는 방법이 없었다. 처음에는 혼란스러웠지만, 열 순서가 고정되어 있다는 점을 발견하고 인덱스로 접근하기로 했다.
인덱스를 통해 데이터를 추출하면서도 몇 가지 추가적인 문제가 있었다. 숫자에 콤마가 포함되어 있었고, 음수는 괄호로 표기된다는 점이었다. 이런 형식을 제대로 처리하지 않으면 잘못된 계산 결과가 나올 수 있었기 때문에, 이를 고려한 문자열 전처리 코드를 작성했다. 여러 가지 형식이 뒤섞여 있는 데이터에서도 정확한 값을 얻어내기 위한 복잡한 코드였다.
import re
from html.parser import HTMLParser
from decimal import Decimal

class TaxInvoiceParser(HTMLParser):
    """국세청 전자세금계산서 HTML. 클래스명이 없어서 열 위치로 잡는다.
    열 순서는 고정이라는 걸 여러 건 열어보고 확인했다."""
    COLS = ['date', 'item', 'spec', 'qty', 'unit_price', 'supply', 'vat']

    def __init__(self):
        super().__init__()
        self.rows, self._row, self._cell, self._in_td = [], [], [], False

    def handle_starttag(self, tag, attrs):
        if tag == 'td':
            self._in_td, self._cell = True, []
        elif tag == 'tr':
            self._row = []

    def handle_data(self, data):
        if self._in_td:
            self._cell.append(data)

    def handle_endtag(self, tag):
        if tag == 'td':
            self._row.append(''.join(self._cell).strip())
            self._in_td = False
        elif tag == 'tr' and len(self._row) >= len(self.COLS):
            self.rows.append(dict(zip(self.COLS, self._row)))


def to_decimal(s: str) -> Decimal:
    """'1,234' → 1234 / '(500)' → -500 / '' → 0"""
    s = (s or '').strip().replace(',', '').replace('원', '')
    if not s:
        return Decimal(0)
    neg = s.startswith('(') and s.endswith(')')
    s = s.strip('()')
    try:
        v = Decimal(s)
    except Exception:
        return Decimal(0)
    return -v if neg else v
국세청 전자세금계산서 HTML 파싱 — 클래스명이 없다
파싱 작업의 핵심은 열 순서에 의존한 인덱싱 접근 방식이었다. 이 방식은 HTML 구조가 크게 변하지 않는 한 안정적으로 데이터를 추출할 수 있다는 장점을 제공했다. 다만, 새로운 열이 추가되거나 순서가 바뀔 때마다 코드를 수정해야 한다는 점은 리스크로 남았다. 그 결과, 전자세금계산서를 수작업으로 확인하던 시간이 대폭 줄어들었고, 정산 과정에서의 실수가 현저히 줄었다. 자동화 시스템의 첫걸음을 떼는 데 중요한 기여를 했다.
같은 상품인데 표기가 다 다르다
과일 주문을 처리하면서 가장 골치 아팠던 문제 중 하나는 상품명이 각기 다르게 표기된다는 점이었다. ‘샤인 2kg 특’부터 ‘샤인머스켓 2키로 상’까지 같은 과일인데도 다양한 표기법이 존재했다. 이는 주문 내역을 자동으로 처리하고 정산하는 데 큰 장애물이 됐다. 이를 해결하기 위해 품목명을 정규화하는 매핑 테이블을 만들었다. 원래는 하드코딩으로 해결하려 했지만, 시간이 갈수록 더 많은 상품이 추가되어 관리가 복잡해졌다. 그래서 매핑 테이블로 정리하기로 했다.
매핑 테이블을 통해 각기 다른 표기를 하나의 표준화된 이름으로 변환할 수 있도록 했다. 이 테이블은 엑셀이나 CSV 파일 형태로 관리할 수 있어, 새로운 상품이 추가되더라도 쉽게 업데이트할 수 있었다. 이렇게 하면 초기 설정에만 손이 가고, 이후부터는 자동으로 매칭되기 때문에 작업 속도가 크게 개선됐다.
import re

# '샤인 2kg 특', '샤인머스켓 2키로 상', '샤인머스켓2K특' 이 다 온다
ALIAS = {
    '샤인': '샤인머스켓', '샤인머스켓': '샤인머스켓', '샤인 머스켓': '샤인머스켓',
    '대추방울': '대추방울토마토', '대추토마토': '대추방울토마토',
    '토마토': '완숙토마토', '완숙': '완숙토마토',
}
GRADE = {'특': 'S', '상': 'A', '보통': 'B', '중': 'B', 'S': 'S', 'A': 'A'}

WEIGHT_PAT = re.compile(r'(\d+(?:\.\d+)?)\s*(kg|k|키로|킬로|g)', re.I)

def normalize_item(raw: str) -> dict:
    s = raw.replace(' ', '')

    # 중량 먼저 떼어낸다
    w = WEIGHT_PAT.search(s)
    weight_kg = None
    if w:
        v, unit = float(w.group(1)), w.group(2).lower()
        weight_kg = v / 1000 if unit == 'g' else v
        s = WEIGHT_PAT.sub('', s)

    # 등급을 뒤에서 찾는다
    grade = None
    for k, v in GRADE.items():
        if s.endswith(k):
            grade, s = v, s[:-len(k)]
            break

    # 남은 게 품목명. 긴 별칭부터 매칭한다
    name = None
    for k in sorted(ALIAS, key=len, reverse=True):
        if k.replace(' ', '') in s:
            name = ALIAS[k]
            break

    return {"name": name or raw, "weight_kg": weight_kg, "grade": grade,
            "matched": name is not None}
같은 상품인데 표기가 다 다르다
매핑 테이블을 사용하면서 가장 눈에 띄는 변화는 정산 과정에서의 오류가 크게 줄어들었다는 점이다. 처음에는 수기로 하나하나 비교해야 했던 부분이 이제는 자동으로 해결되니 시간 절약은 물론, 손실되는 정보도 거의 없게 됐다. 다만, 매핑 테이블을 만드는 초기 단계에서 여러 가지 변수에 맞게 완벽히 설정하는 데 시간이 좀 걸렸다. 하지만 한 번 제대로 설정해 놓으면 이후에는 유지보수에 드는 비용이 거의 없어서 크게 줄었다.
수수료 규칙을 코드에서 빼낸 이유
프로젝트 초기에는 수수료 계산 로직을 코드에 직접 하드코딩했다. 산지마다 수수료와 택배비 규칙이 달랐기 때문에, 코드에 직접 수수료 규칙을 추가하는 방식이 처음에는 간편해 보였다. 하지만 새로운 산지가 추가될 때마다 코드를 수정해야 했고, 이는 코드의 유지보수성을 떨어뜨렸다. 이러한 방식은 시간이 지나면서 오래 못 갈 방식이라는 걸 알게 되었다. 산지가 늘어날 때마다 이와 같은 작업이 반복되면 프로젝트 확장에 큰 장애물이 될 것으로 예상되었다.
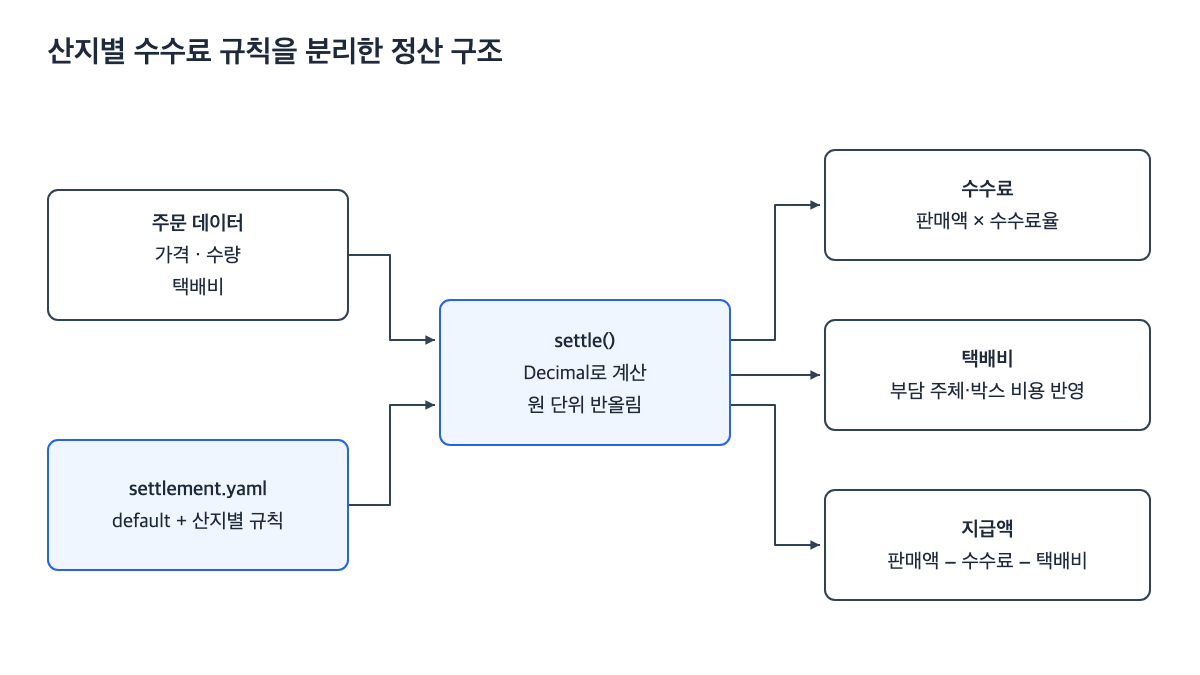
그래서 수수료 규칙을 코드에서 설정 파일로 분리하기로 했다. 설정 파일을 사용하면 산지별로 다른 수수료 규칙을 손쉽게 추가할 수 있게 된다.
# settlement.yaml
farms:
  farm_a:
    commission_rate: 0.15        # 판매가 대비 수수료
    shipping_payer: seller       # 택배비를 내가 부담
    box_cost: 1200
  farm_b:
    commission_rate: 0.12
    shipping_payer: farm         # 산지가 부담
    box_cost: 0
default:
  commission_rate: 0.15
  shipping_payer: seller
  box_cost: 1200
  vat_rate: 0.10

# ── settle.py
from decimal import Decimal, ROUND_HALF_UP
import yaml

CFG = yaml.safe_load(open('settlement.yaml', encoding='utf-8'))

def krw(v) -> Decimal:
    return Decimal(v).quantize(Decimal('1'), rounding=ROUND_HALF_UP)


def settle(order, farm_key: str) -> dict:
    rule = {**CFG['default'], **CFG['farms'].get(farm_key, {})}
    gross = Decimal(order['price']) * order['qty']

    commission = krw(gross * Decimal(str(rule['commission_rate'])))
    shipping   = (krw(order['shipping_fee'] + rule['box_cost'])
                  if rule['shipping_payer'] == 'seller' else Decimal(0))
    payout     = gross - commission - shipping

    return {
        "farm": farm_key, "gross": gross,
        "commission": commission, "shipping": shipping,
        "payout": payout,
        "vat": krw(commission * Decimal(str(rule['vat_rate']))),
    }
수수료 규칙은 설정으로 뺀다 — 산지가 늘 때마다 코드를 고칠 수 없다
설정 파일에 수수료 규칙을 정의하면, 코드에서는 단순히 이 파일을 읽어와 계산에 활용하면 된다. 이는 코드의 복잡성을 낮추고, 새로운 산지가 추가될 때 매우 유연하게 대응할 수 있게 만들어 주었다.
규칙을 설정 파일로 분리한 후, 수수료 계산 과정에서의 오류도 눈에 띄게 줄었다. 파일에 규칙이 명확하게 정의되어 있기 때문에 오류를 찾아내기도 쉬워졌다. 수수료 규칙을 간단히 추가하거나 수정할 수 있어서, 변화하는 요구사항에도 빠르게 대응할 수 있었다. 이는 프로젝트 유지보수의 큰 개선을 가져왔고, 덕분에 반복적으로 코드를 수정하는 번거로움에서 벗어날 수 있었다.
알림과 대시보드
수작업으로 진행하던 정산 과정을 자동화하고 나니, 주문과 재고 상태를 실시간으로 모니터링하는 것이 중요해졌다. 이를 위해 n8n을 활용해 알림 시스템을 구축했다. n8n은 워크플로우 자동화 툴로, 다양한 서비스와의 연동을 쉽게 할 수 있다. 주문이 들어오면 바로 텔레그램으로 알림이 오도록 설정했다. 덕분에 새로운 주문이 들어와도 즉각적으로 확인할 수 있었고, 재고 관리에도 큰 도움이 되었다.
재고가 기준치 아래로 떨어지면 텔레그램을 통해 경고 메시지를 받도록 설정했다. 이 기능을 통해 판매 중단 사태를 미연에 방지할 수 있었다. 처음에는 수작업으로 재고 상태를 확인했지만, 이제는 자동화된 알림 덕분에 야간에도 신경 쓸 필요가 없어졌다. 알림 시스템을 통해 업무 속도를 높일 수 있었고, 시간을 다른 중요한 일에 더 투자할 수 있게 되었다.
대시보드는 홈서버에 컨테이너로 올려 실시간으로 데이터를 시각화했다. 이렇게 해서 폰에서도 언제든지 데이터를 확인할 수 있도록 했다. 대시보드는 현재 주문 상황, 재고 상태, 매출 등을 한눈에 볼 수 있게 구성했다. 초반에는 시각화 툴 선택에 시간이 걸렸지만, 최종적으로 만족스러운 결과물을 얻을 수 있었다. 덕분에 데이터에 기반한 의사결정을 더 빠르고 정확하게 할 수 있었다.
알림 시스템과 대시보드 덕분에 정산 과정을 포함한 사업 운영 전반이 이전보다 훨씬 원활해졌다. 실시간으로 데이터를 모니터링하고 이에 즉각 대응할 수 있는 체계를 갖추게 되니, 사업의 안정성이 크게 향상되었다. 이 과정에서 n8n과 컨테이너 기술의 장점을 충분히 경험할 수 있었다. 앞으로도 이 시스템을 유지하고 발전시켜 나갈 예정이다.
5분으로 줄었다
전자세금계산서 파싱과 품목명 정규화, 그리고 수수료 계산의 자동화 덕분에 정산에 걸리는 시간이 대폭 줄었다. 과거에는 매일 저녁 몇 시간을 투자해야 했던 작업이 이제는 단 몇 분 만에 완료된다. 이처럼 시간적 여유가 생기면서 다른 중요한 업무에 더 많은 집중을 쏟을 수 있게 되었다. 덜 피곤해진 덕분인지 업무 효율도 자연스럽게 올라갔다.
또한, 수작업에서 벗어나 자동화된 시스템으로 전환하면서 실수가 줄었다. 이전에는 엑셀 파일을 열고 여러 문서를 수작업으로 교차 확인해야 했으니 오류가 발생할 위험이 컸다. 하지만 이제는 설정 파일과 매핑 테이블을 기반으로 모든 계산이 자동으로 이루어지므로 이런 걱정을 덜 수 있게 되었다. 실수로 인한 불필요한 비용이나 시간 낭비가 줄어들어 마음이 한결 편하다.
자동화 시스템을 구축하기 전에는 정산 시간이 부담으로 느껴졌다. 그러나 이젠 업무의 부담감 없이 산지와의 관계 증진과 더 나은 고객 서비스에 집중할 수 있다. 게다가 다른 프로젝트나 새로운 기술을 배우는 데 시간을 할애할 수 있다는 점이 큰 장점이다. 자동화 덕분에 얻은 시간과 에너지를 어떻게 활용할지 고민하고, 앞으로도 더 나은 방향으로 발전시키는 기회로 삼고 있다.
함께 볼 글
이 글과 이어지는 내용은 아래에 정리해뒀다.
